算力环境交付(选配)
预装驱动、CUDA/cuDNN 与模型运行环境,到货即可投入业务调试。
您正在使用的浏览器兼容模式或旧版 WebView 不支持官网的现代页面样式。 请切换到浏览器“极速模式”,或使用最新版 Edge、Chrome、Safari、微信内置浏览器访问。
如需咨询国产 PC、国产工作站、移动工作站、服务器或计算集群,可直接联系我们。
AI 训练推理 · 新一代 GPU 算力
航天智算
RTX 5090 32GB GDDR7,新一代 GPU 算力整机
基于 NVIDIA RTX 5090(32GB GDDR7),面向本地大模型部署、AI 训练与微调、批量推理和渲染仿真场景,提供单卡/4卡/8卡整机定制。显存与算力较上一代进一步提升,适合更大参数量模型与更高并发推理;GPU 算力产品线与信创算力产品线并行互补。
无需先确定型号,提交软件或任务信息即可开始沟通。
需求整理
选择 GPU 型号、整机形态、卡数与用途,一键生成配置清单并提交询盘。
RTX 4090 生态成熟,RTX 5090 32GB 大显存面向新一代模型;拿不准就交给我们推荐。
系统会根据 GPU 型号自动限制可选卡数。
单卡机型配桌面旗舰(AMD / Intel),2 卡及以上配双路服务器平台(EPYC / 至强 6,×2 颗);切换形态时系统自动匹配。
4U 四卡机架型 + RTX 4090 24GB 的可交付卡数组合。
选择内存、存储和网络,形成整机初步配置。
内存
存储
网络
主要用途
说明:4 卡及以上整机需要根据主板 PCIe 拓扑、Riser、供电、散热与机箱风道进行项目评估;GPU 行情波动较大,价格以询价确认为准。
预装驱动、CUDA/cuDNN 与模型运行环境,到货即可投入业务调试。
按数据规模定制网络、存储与多机互联方案,可衔接算力集成服务。
建议先提供模型名称、数据规模与并发要求,我们按负载确认卡数、存储与网络配置,并给出整机报价与交付计划。预算有限或以成熟生态优先时,可对比 4090 方案。
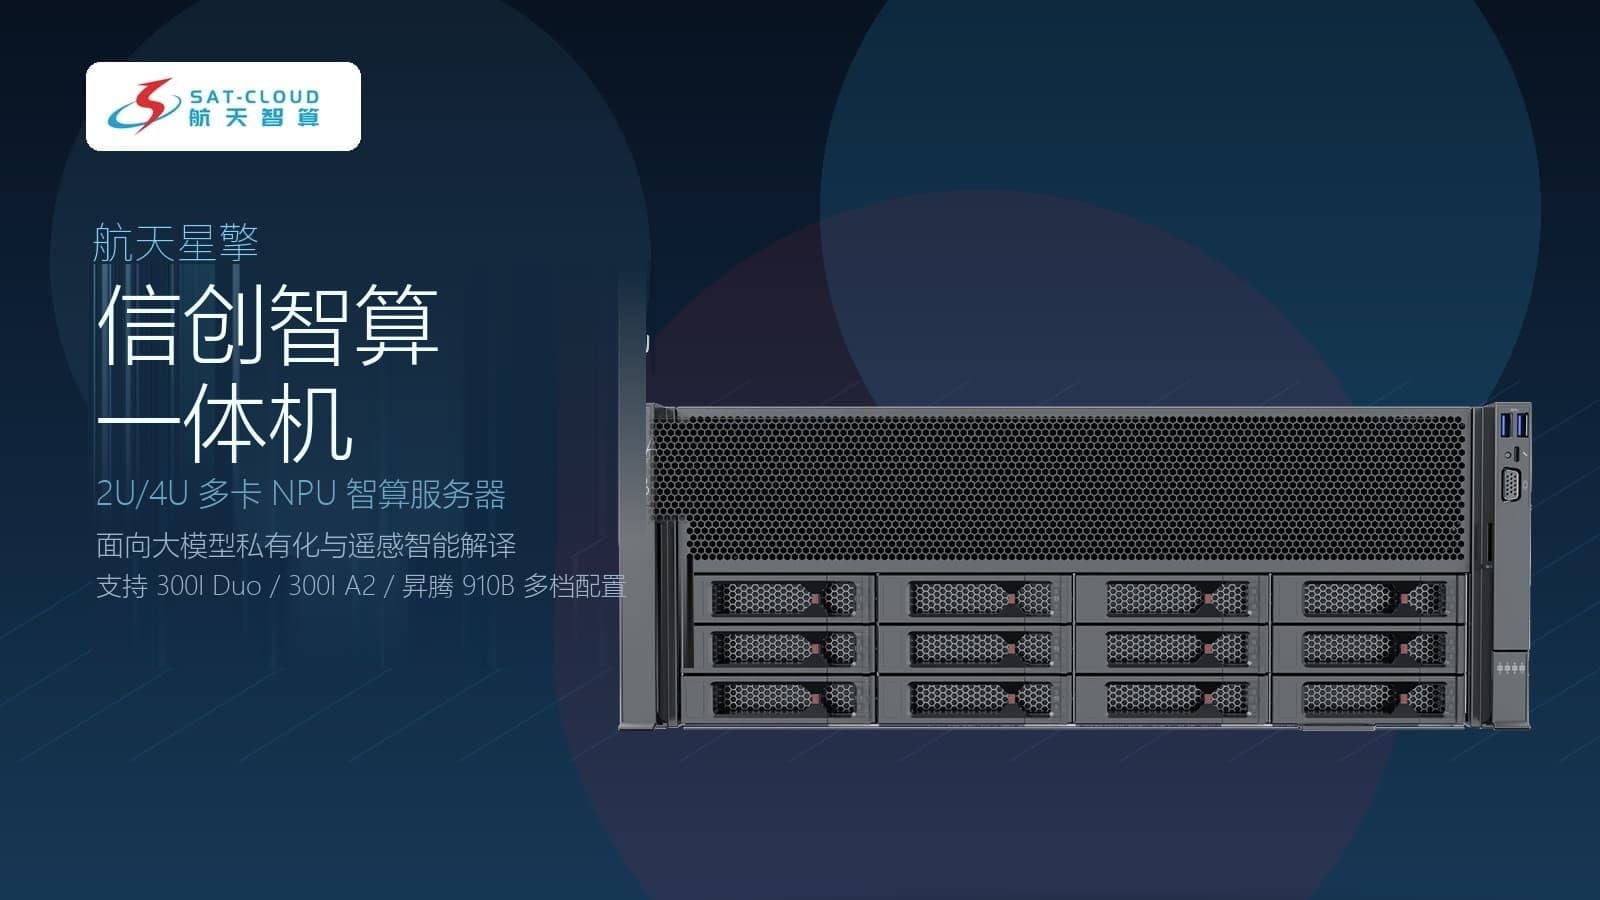
信创 NPU 与 GPU 两条产品线并行互补,按业务负载与合规要求选型;点击查看对应机型的配置与选型页。
单卡 FP16 140 TFLOPS / 96GB 大显存,2 卡起步的高性价比推理方案。
单卡 FP16 280 TFLOPS / 64GB 大显存,主力大模型推理机型。
8 卡训练整机,大模型训练微调与科研智算,可扩展集群。
950PR 平台 4 卡全互联整机(最大 1784 TFLOPS / 128GB),LLM 推理与推荐场景。